

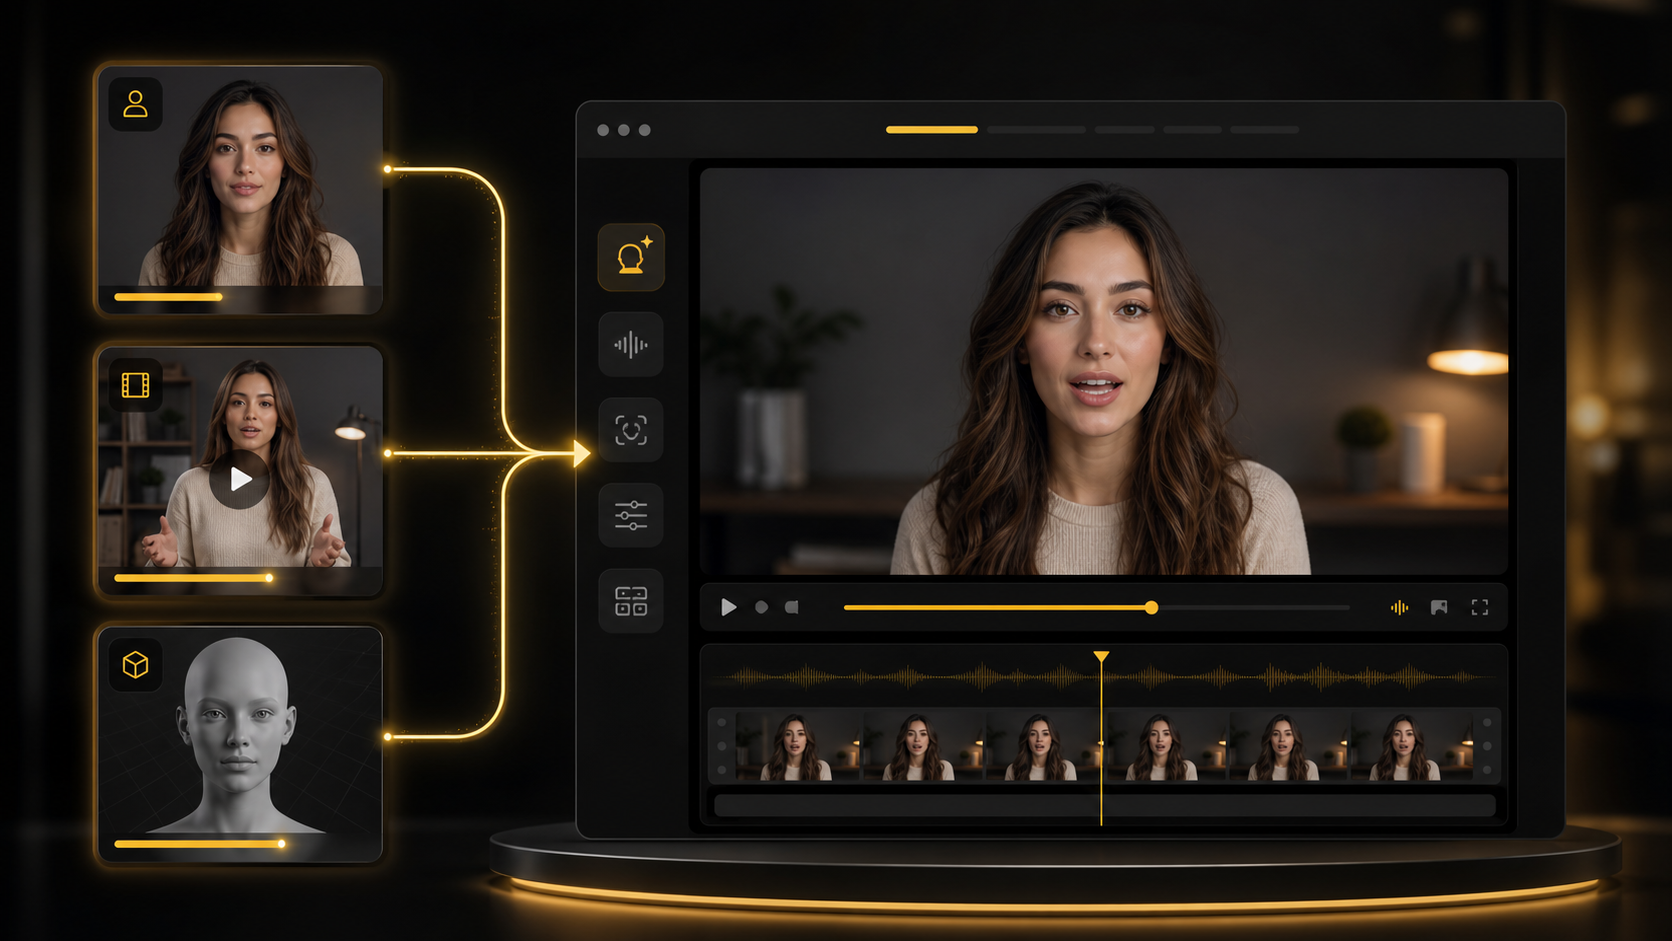
スタジオのプレビュー
ソース
音声
レンダリング
写真、ビデオ、アバターの入力
ソース映像を用意していない場合は、鮮明なポートレート、既存のビデオ、サンプル アバター、または AI 生成のアバター画像から始めます。
画像/ビデオ入力アバターの準備完了
1. 動画をアップロード
2. テキストを入力、または音声をアップロード・録音
3. モデルを選択
Fast の出力解像度は自動で決まります。720p を選択すると Pro に切り替わります。
1080p、2K、4K は Pro の 720p 動画を高画質化して生成されます。高画質化しても顔の歪みが修正されない場合があります。
最近の生成結果はまだありません。
AudioToVideoAIのスタジオ
AudioToVideoAIのスタジオ は、カメラ クルーやデスクトップ編集セットアップなしで、早口ビデオ、ミュージック クリップ、翻訳ビデオ、2 人の会話シーンを必要とするクリエイター向けのブラウザ ベースの AI リップ シンク ワークスペースです。
ソース メディアから同期ビデオへ
スタジオはソース メディア、音声入力、モデル選択、プレビュー、エクスポート コントロールを組み合わせて、アイデアから完成したリップシンク ビデオまで 1 か所で移行できます。
ソース映像を用意していない場合は、鮮明なポートレート、既存のビデオ、サンプル アバター、または AI 生成のアバター画像から始めます。

アップロードされたオーディオ、ブラウザー録音、生成された音声、またはローカリゼーション ワークフロー用の翻訳されたスクリプトを使用して口の動きを促進します。
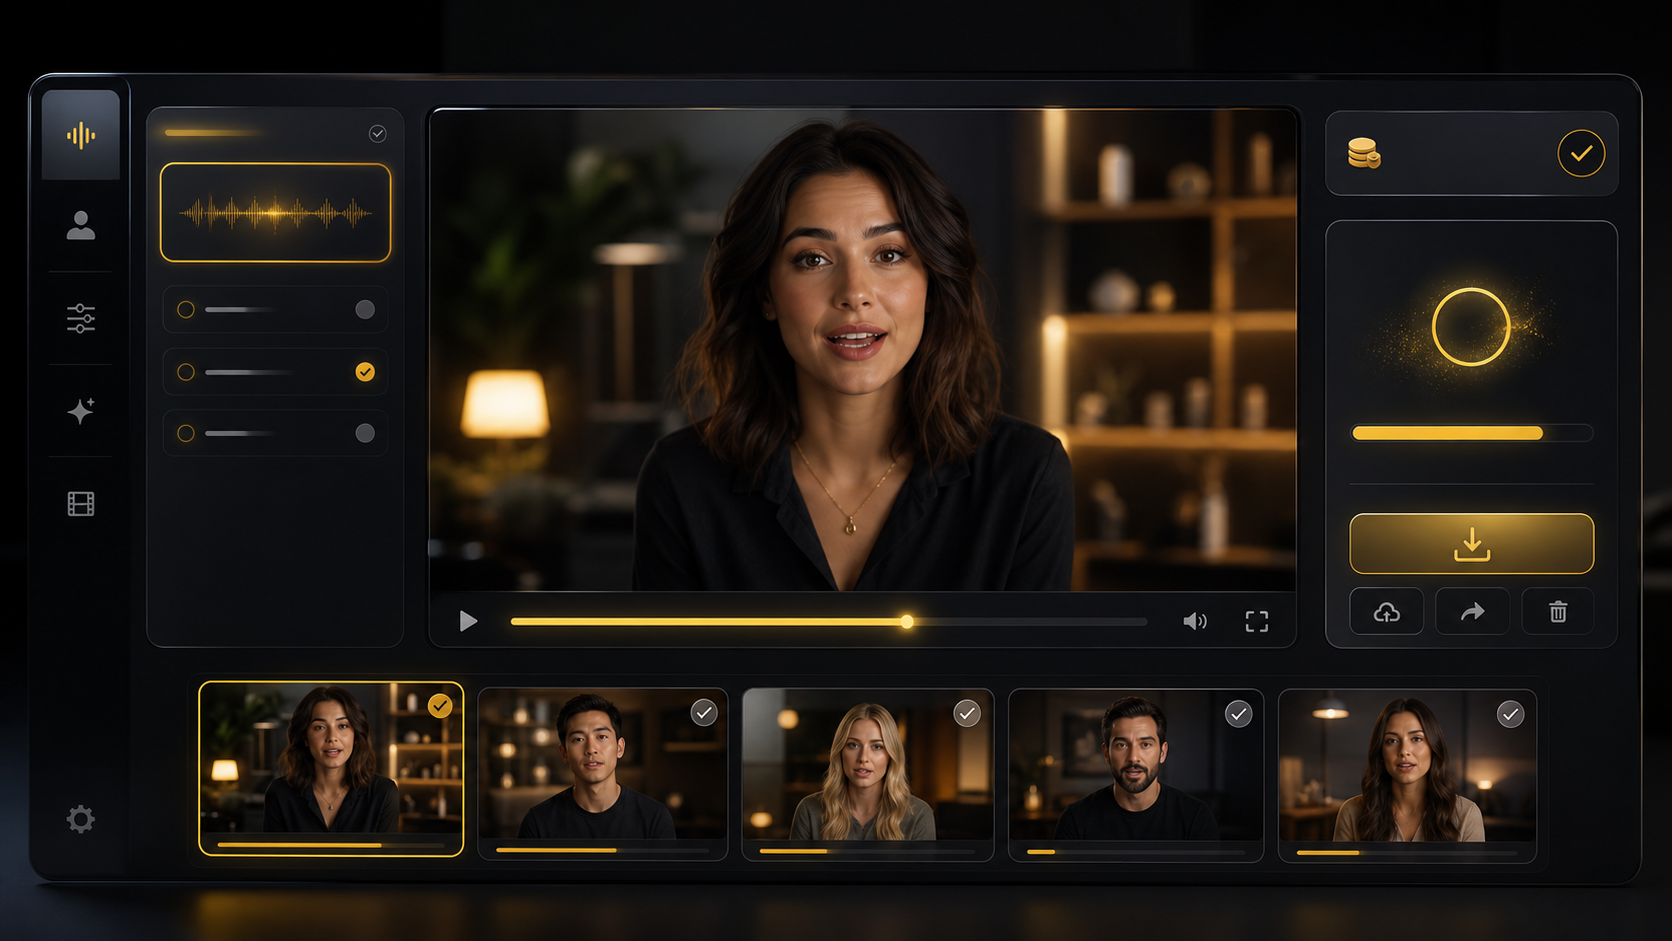
完全な出力にクレジットを費やす前に、タイミング、音声、解像度、モデルの選択を確認してください。
きれいなリップ シンクの結果は、顔のソース、駆動音声またはスクリプト、最終レンダリングのモデル設定という 3 つの決定によって決まります。
ステップ 1
正面向きの画像をアップロードするか、既存のビデオを使用するか、組み込みのアバターを選択するか、スタジオ 内で直接新しいアバター画像を生成します。
ステップ 2
レンダリング前に、オーディオのアップロード、ブラウザでの録音、テキスト読み上げ用のスクリプトの貼り付け、またはビデオ スクリプトの翻訳を行います。
ステップ 3
リップ シンク モデルと解像度を選択し、推定クレジットを確認して、ライブラリからダウンロードまたは開くことができるビデオを生成します。
制作ステップごとにツールを切り替えるのではなく、プロジェクトに一致する入力形式を使用します。
ポートレート、ホスト、製品キャラクター、ペット、または様式化されたアバターを短いトークビデオに変換します。
口の動きをナレーション、歌、ポッドキャスト、広告、またはナレーション トラックに合わせます。
スクリプトを抽出または追加し、翻訳された音声をプレビューし、同期した口の動きでローカライズされたビデオを生成します。
ビデオに話し顔、翻訳された音声、または新たに撮影せずに再利用可能なプレゼンターが必要な場合は、AudioToVideoAIのスタジオ を使用します。
TikTok、リール、ショート、有料ソーシャル キャンペーンの複数の広報担当者、言語、スクリプトをテストします。
オーディオから歌っている写真スタイルのクリップ、歌詞の瞬間、ミーム ビデオ、パフォーマンス スタイルのビジュアルを作成します。
製品の説明、コースのレッスン、デモ、クリエイターのビデオを同期音声で新しい視聴者に適応させます。
2 人の講演者が 1 つのフレーム内で交代するインタビュー、ポッドキャスト、ロールプレイ、セールス、または教育クリップを作成します。
このスタジオは、繰り返し制作できるように設計されています。明確な入力、目に見えるコスト、再利用可能な結果、不良レンダリングが発生する前に減らすのに役立つコントロールが備わっています。
簡単なテストには高速なモデルを選択し、タイミング、解像度、または長いオーディオが重要な場合には高品質のモデルを選択します。
ページを離れることなく、画像のトリミング、アバターの生成、音声スタイルの変更、音声のプレビュー、および長時間の音声コストの問題からの回復を行います。
最近の出力は スタジオ に表示されたままになり、完了したジョブは後で [マイ クリエイション] からダウンロード、共有、または開くことができます。
スタジオ は生成前に推定クレジットを表示するため、完全なレンダリングをコミットする前にオーディオの長さ、モデル、解像度を調整できます。
コスト管理のために構築
オーディオ プレビューは、最終レンダリング前は無料のままです。
信用見積りは期間と解像度に応じて更新されます。
追加プロンプトでは現在の設定が保存されます。
AudioToVideoAIのスタジオ は、オンラインで AI リップシンクビデオを作成するための AudioToVideoAI ワークスペースです。メディアのアップロード、オーディオまたはスクリプトの入力、モデル設定、プレビュー、レンダリング、ダウンロード、ライブラリへのアクセスを 1 つのページにまとめています。
はい。ポートレートをアップロードするか、サンプル アバターを選択し、音声またはスクリプトを追加して、口の動きを同期させたトーキング ビデオを生成します。
はい。ビデオ翻訳モードは、ソース ビデオ、スクリプト抽出、翻訳されたテキスト、オーディオ プレビュー、ローカリゼーション プロジェクトのリップシンク出力を操作できます。
スタジオ は最大 10 分のオーディオ クリップをサポートします。クリップが長いと、より多くのクレジットがかかる可能性があるため、このページには、最終レンダリングの前に見積もりと回復オプションが表示されます。
通常、口が見える明確な正面顔が最良の結果を生み出します。適切な照明、鮮明な画像、きれいな音声により、モデルはより自然な口の動きを作成できます。
いいえ。メインのリップ シンク モードは 1 人の話者に適しており、マルチダイアログ モードは別の話者ラベルと音声を使用する 2 人のシーン向けに設計されています。