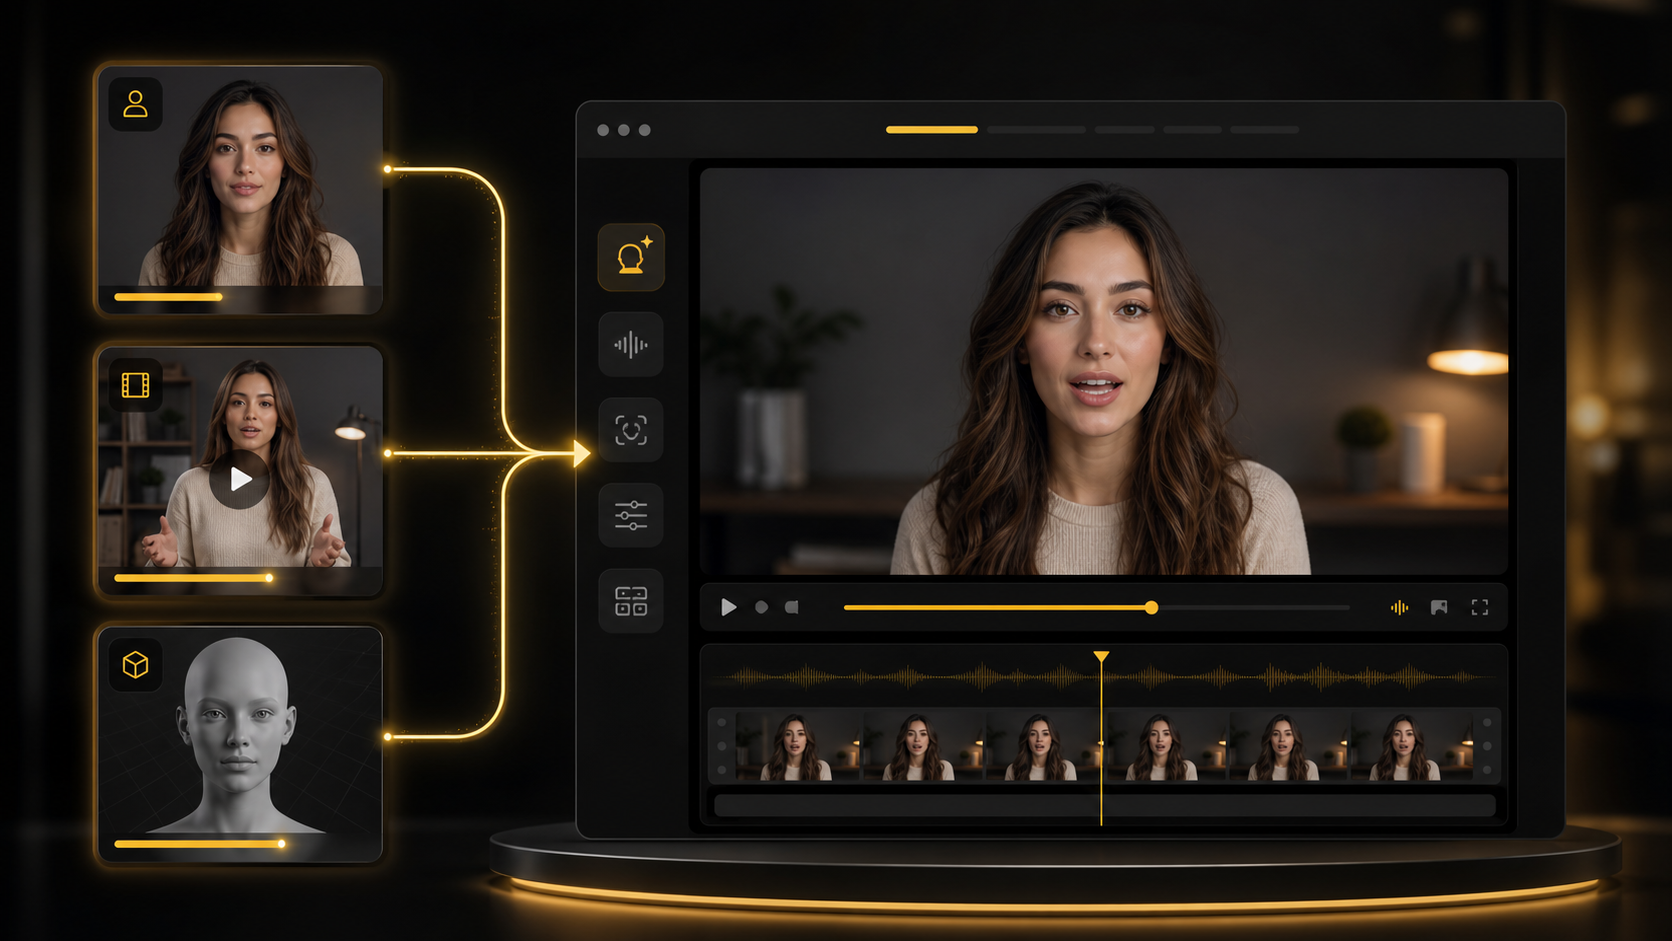
Đầu vào ảnh, video và hình đại diện
Bắt đầu bằng ảnh chân dung rõ ràng, video hiện có, hình đại diện mẫu hoặc hình ảnh đại diện do AI tạo khi bạn chưa có sẵn cảnh quay nguồn.
1. Upload Video
2. Enter your text, upload or record audio
3. Model Selection
Fast tự động xác định độ phân giải đầu ra. Chọn 720p để chuyển sang Pro.
1080p, 2K và 4K được nâng cao từ video Pro 720p. Việc nâng cao có thể không khắc phục được biến dạng khuôn mặt.
No recent outputs yet.
Lipsync Studio
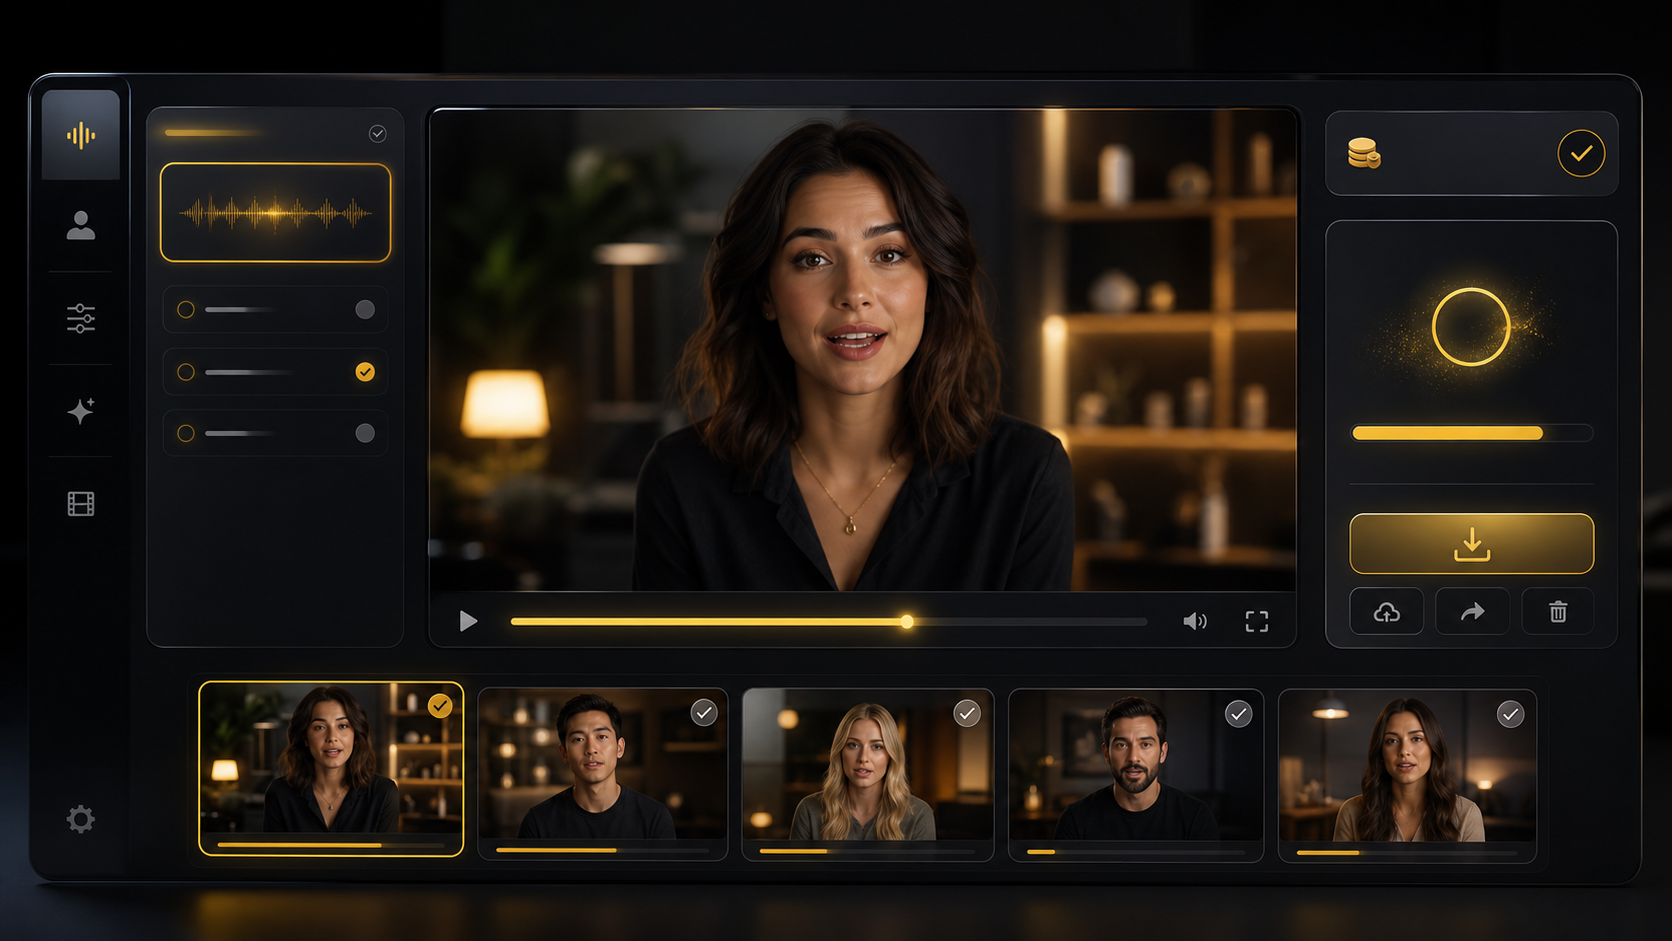
AudioToVideoAI Studio là không gian làm việc hát nhép AI dựa trên trình duyệt dành cho những người sáng tạo cần video nói nhanh, clip nhạc, video đã dịch và cảnh đối thoại hai người mà không cần đội quay phim hoặc thiết lập chỉnh sửa trên máy tính để bàn.

Từ phương tiện nguồn đến video được đồng bộ hóa
Studio kết hợp các điều khiển phương tiện nguồn, đầu vào bằng giọng nói, lựa chọn mô hình, xem trước và xuất để bạn có thể chuyển từ ý tưởng sang video được hát nhép hoàn chỉnh ở một nơi.

Bắt đầu bằng ảnh chân dung rõ ràng, video hiện có, hình đại diện mẫu hoặc hình ảnh đại diện do AI tạo khi bạn chưa có sẵn cảnh quay nguồn.

Thúc đẩy chuyển động của miệng bằng âm thanh được tải lên, bản ghi trình duyệt, giọng nói được tạo hoặc tập lệnh được dịch cho quy trình bản địa hóa.

Kiểm tra thời gian, giọng nói, độ phân giải và lựa chọn kiểu máy trước khi sử dụng tín dụng cho toàn bộ đầu ra.
Kết quả đồng bộ hóa môi rõ ràng phụ thuộc vào ba quyết định: nguồn khuôn mặt, âm thanh hoặc tập lệnh điều khiển và cài đặt mô hình cho kết xuất cuối cùng.
Bước 1
Tải lên hình ảnh mặt trước, sử dụng video hiện có, chọn hình đại diện tích hợp hoặc tạo hình đại diện mới trực tiếp trong Studio.
Bước 2
Tải lên âm thanh, ghi trong trình duyệt, dán tập lệnh để chuyển văn bản thành giọng nói hoặc dịch tập lệnh video trước khi hiển thị.
Bước 3
Chọn kiểu và độ phân giải hát nhép, xem xét phần ghi công ước tính, sau đó tạo video có thể tải xuống hoặc mở từ thư viện của bạn.
Sử dụng định dạng đầu vào phù hợp với dự án của bạn thay vì chuyển đổi công cụ cho từng bước sản xuất.
Biến ảnh chân dung, người dẫn chương trình, nhân vật sản phẩm, thú cưng hoặc hình đại diện cách điệu thành video nói chuyện ngắn.
Kết hợp chuyển động của miệng với phần lồng tiếng, bài hát, podcast, quảng cáo hoặc bản tường thuật.
Trích xuất hoặc thêm tập lệnh, xem trước âm thanh đã dịch và tạo video đã bản địa hóa với chuyển động miệng đồng bộ.
Sử dụng Lipsync Studio khi video cần khuôn mặt nói, giọng nói được dịch hoặc người thuyết trình có thể sử dụng lại mà không cần quay mới.
Kiểm tra nhiều người phát ngôn, ngôn ngữ và tập lệnh cho TikTok, Câu chuyện, Video ngắn và các chiến dịch xã hội trả phí.
Tạo clip theo phong cách ảnh ca hát, khoảnh khắc trữ tình, video meme và hình ảnh mang phong cách biểu diễn từ âm thanh.
Điều chỉnh trình giải thích sản phẩm, bài học khóa học, bản trình diễn và video của người sáng tạo cho khán giả mới bằng giọng nói được đồng bộ hóa.
Xây dựng các clip phỏng vấn, podcast, nhập vai, bán hàng hoặc giáo dục trong đó hai diễn giả thay phiên nhau trong một khung hình.
Studio được thiết kế để sản xuất lặp lại: đầu vào rõ ràng, chi phí hiển thị, kết quả có thể sử dụng lại và các biện pháp kiểm soát giúp giảm kết xuất xấu trước khi chúng xảy ra.
Chọn các mô hình nhanh hơn để kiểm tra nhanh hoặc các mô hình chất lượng cao hơn khi có vấn đề về thời gian, độ phân giải hoặc âm thanh dài hơn.
Cắt hình ảnh, tạo hình đại diện, thay đổi kiểu giọng nói, xem trước giọng nói và khôi phục sau các vấn đề về chi phí âm thanh dài mà không cần rời khỏi trang.
Các kết quả đầu ra gần đây vẫn hiển thị trong Studio và các công việc đã hoàn thành có thể được tải xuống, chia sẻ hoặc mở sau từ Sáng tạo của tôi.
Studio hiển thị phần ghi công ước tính trước khi tạo, do đó bạn có thể điều chỉnh độ dài, kiểu và độ phân giải âm thanh trước khi thực hiện hiển thị đầy đủ.
Được xây dựng để kiểm soát chi phí
Bản xem trước âm thanh vẫn miễn phí trước lần kết xuất cuối cùng.
Cập nhật ước tính tín dụng cùng với thời lượng và độ phân giải.
Lời nhắc nạp tiền duy trì thiết lập hiện tại của bạn.
Lipsync Studio là không gian làm việc AudioToVideoAI để tạo video hát nhép trực tuyến bằng AI. Nó kết hợp tải lên phương tiện, đầu vào âm thanh hoặc tập lệnh, cài đặt mô hình, xem trước, kết xuất, tải xuống và truy cập thư viện trong một trang.
Có. Tải ảnh chân dung lên hoặc chọn hình đại diện mẫu, thêm âm thanh hoặc tập lệnh, sau đó tạo video nói chuyện với cử động miệng đồng bộ.
Có. Chế độ dịch video có thể hoạt động với video nguồn, trích xuất tập lệnh, văn bản đã dịch, xem trước âm thanh và đầu ra được đồng bộ hóa nhép cho các dự án bản địa hóa.
Studio hỗ trợ các clip âm thanh tối đa 10 phút. Các clip dài hơn có thể tốn nhiều tín dụng hơn, vì vậy trang này hiển thị các ước tính và tùy chọn khôi phục trước khi hiển thị cuối cùng.
Mặt trước rõ ràng và miệng nhìn rõ thường mang lại kết quả tốt nhất. Ánh sáng tốt, hình ảnh sắc nét và âm thanh rõ ràng giúp người mẫu tạo ra chuyển động miệng tự nhiên hơn.
Không. Chế độ hát nhép chính hoạt động tốt cho một loa và chế độ đa hội thoại được thiết kế cho các cảnh hai người có nhãn và giọng nói riêng biệt.