

工作室预览
来源
语音
渲染
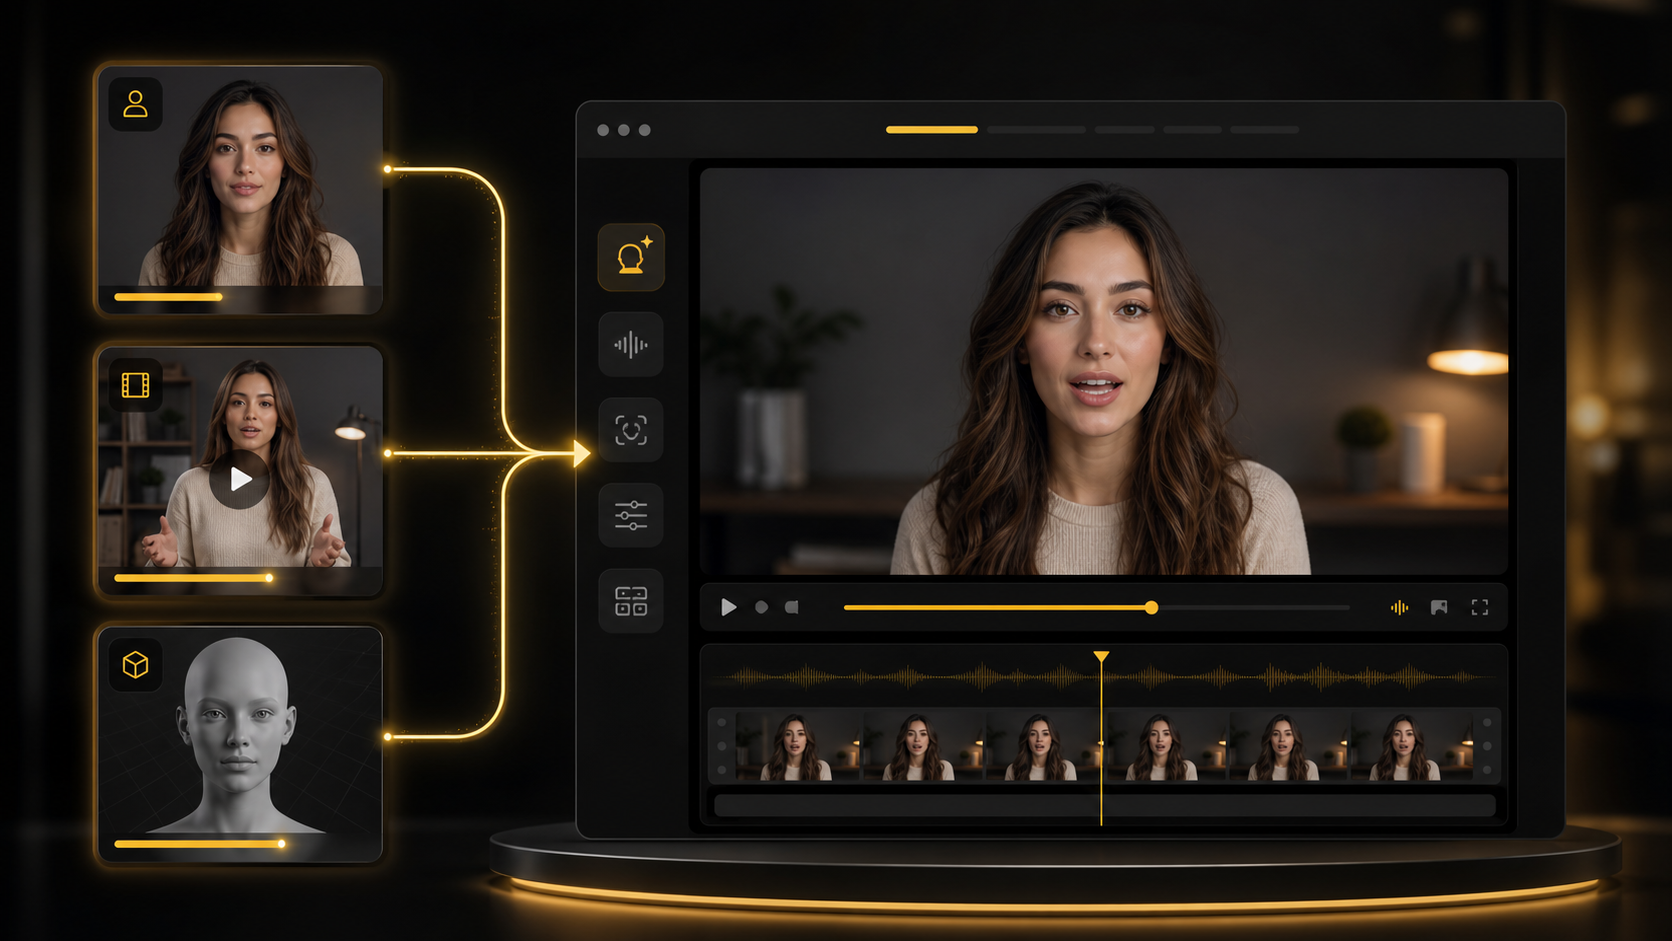
照片、视频和头像输入
当您没有准备好源素材时,从清晰的肖像、现有视频、示例头像或 AI 生成的头像图像开始。
图像/视频输入头像准备就绪
1. 上传视频
2. 输入文字、上传音频或录音
3. 选择模型
Fast 使用自动输出分辨率。选择 720p 将自动切换至 Pro。
1080p、2K 和 4K 均由 Pro 720p 视频增强生成。增强处理可能无法修复面部失真。
还没有最近输出。
Lipsync Studio
AudioToVideoAI Studio 是一个基于浏览器的 AI 口型同步工作区,适合需要快速谈话视频、音乐剪辑、翻译视频和两人对话场景而无需摄像人员或桌面编辑设置的创作者。
从源媒体到同步视频
该工作室结合了源媒体、语音输入、模型选择、预览和导出控件,因此您可以在一个地方将想法转变为完成的口型同步视频。
当您没有准备好源素材时,从清晰的肖像、现有视频、示例头像或 AI 生成的头像图像开始。

通过上传的音频、浏览器录音、生成的语音或本地化工作流程的翻译脚本来驱动嘴部运动。
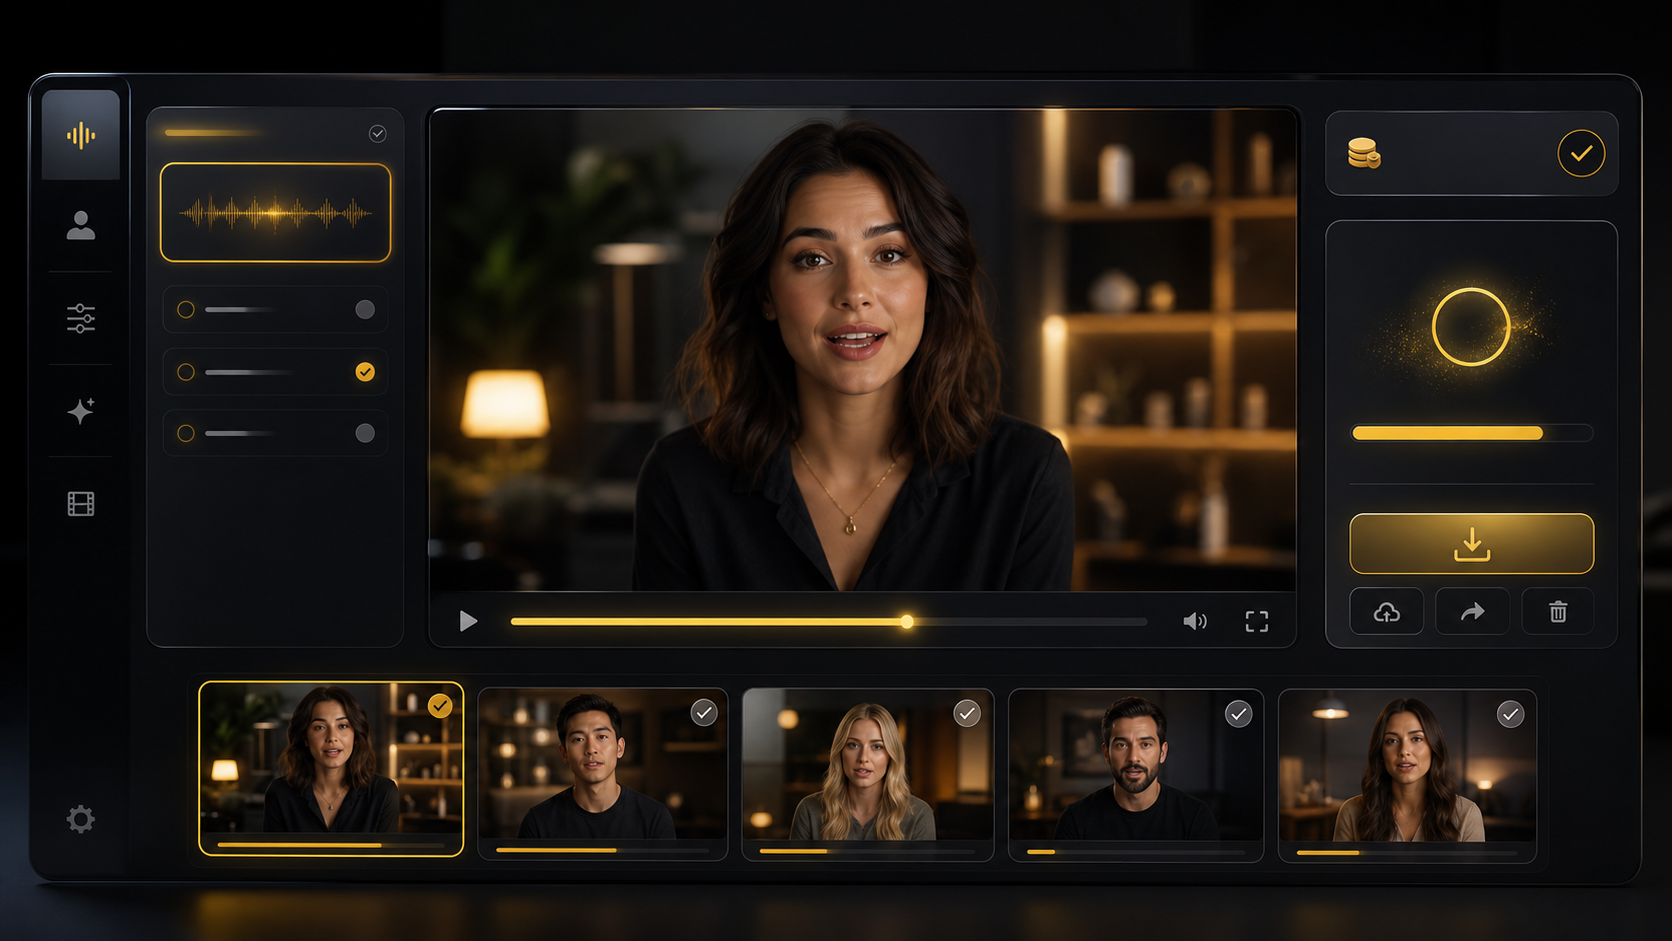
在完整输出上花费积分之前检查时序、语音、分辨率和模型选择。
干净的唇形同步结果取决于三个决定:面部源、驱动音频或脚本以及最终渲染的模型设置。
步骤 1
上传正面图像、使用现有视频、选择内置头像或直接在 Studio 内生成新的头像图像。
步骤 2
上传音频、在浏览器中录制、粘贴文本转语音脚本或在渲染之前翻译视频脚本。
第 3 步
选择口型同步模型和分辨率,查看估计的制作人员名单,然后生成可从您的媒体库下载或打开的视频。
使用与您的项目匹配的输入格式,而不是为每个生产步骤切换工具。
将肖像、主持人、产品角色、宠物或风格化头像变成简短的谈话视频。
将嘴部运动与画外音、歌曲、播客、广告或旁白轨道相匹配。
提取或添加脚本,预览翻译后的音频,并生成具有同步嘴部运动的本地化视频。
当视频需要说话的面孔、翻译的声音或可重复使用的演示者而无需重新拍摄时,请使用 Lipsync Studio。
测试 TikTok、Reels、Shorts 和付费社交活动的多个发言人、语言和脚本。
从音频创建歌唱照片风格的剪辑、抒情时刻、表情包视频和表演风格的视觉效果。
通过同步演讲为新受众调整产品解释、课程、演示和创作者视频。
构建采访、播客、角色扮演、销售或教育剪辑,其中两个发言者在一帧中轮流发言。
该工作室专为重复制作而设计:清晰的输入、可见的成本、可重复使用的结果以及有助于在不良渲染发生之前减少不良渲染的控件。
当时序、分辨率或较长的音频很重要时,选择更快的模型进行快速测试或更高质量的模型。
无需离开页面即可裁剪图像、生成头像、更改语音风格、预览语音以及从长音频成本问题中恢复。
最近的输出在 Studio 中保持可见,完成的作业可以在以后从“我的创作”中下载、共享或打开。
Studio 在生成之前显示估计的制作人员名单,因此您可以在进行完整渲染之前调整音频长度、模型和分辨率。
专为成本控制而构建
音频预览在最终渲染之前保持免费。
信用估计随着持续时间和解决方案而更新。
充值提示保留您当前的设置。
Lipsync Studio 是用于在线创建 AI 唇形同步视频的 AudioToVideoAI 工作区。它将媒体上传、音频或脚本输入、模型设置、预览、渲染、下载和库访问结合在一页中。
是的。上传肖像或选择示例头像,添加音频或脚本,然后生成带有同步嘴部运动的谈话视频。
是的。视频翻译模式可以与源视频、脚本提取、翻译文本、音频预览和口型同步输出一起用于本地化项目。
Studio 支持长达 10 分钟的音频剪辑。较长的剪辑可能会花费更多的积分,因此页面会在最终渲染之前显示估计和恢复选项。
带有可见嘴巴的清晰正面通常会产生最佳效果。良好的照明、清晰的图像和干净的音频有助于模型创建更自然的嘴巴运动。
否。主唇形同步模式适用于一个发言者,而多对话模式专为具有单独发言者标签和声音的两人场景而设计。