

ดูตัวอย่างสตูดิโอ
ที่มา
เสียง
แสดงผล
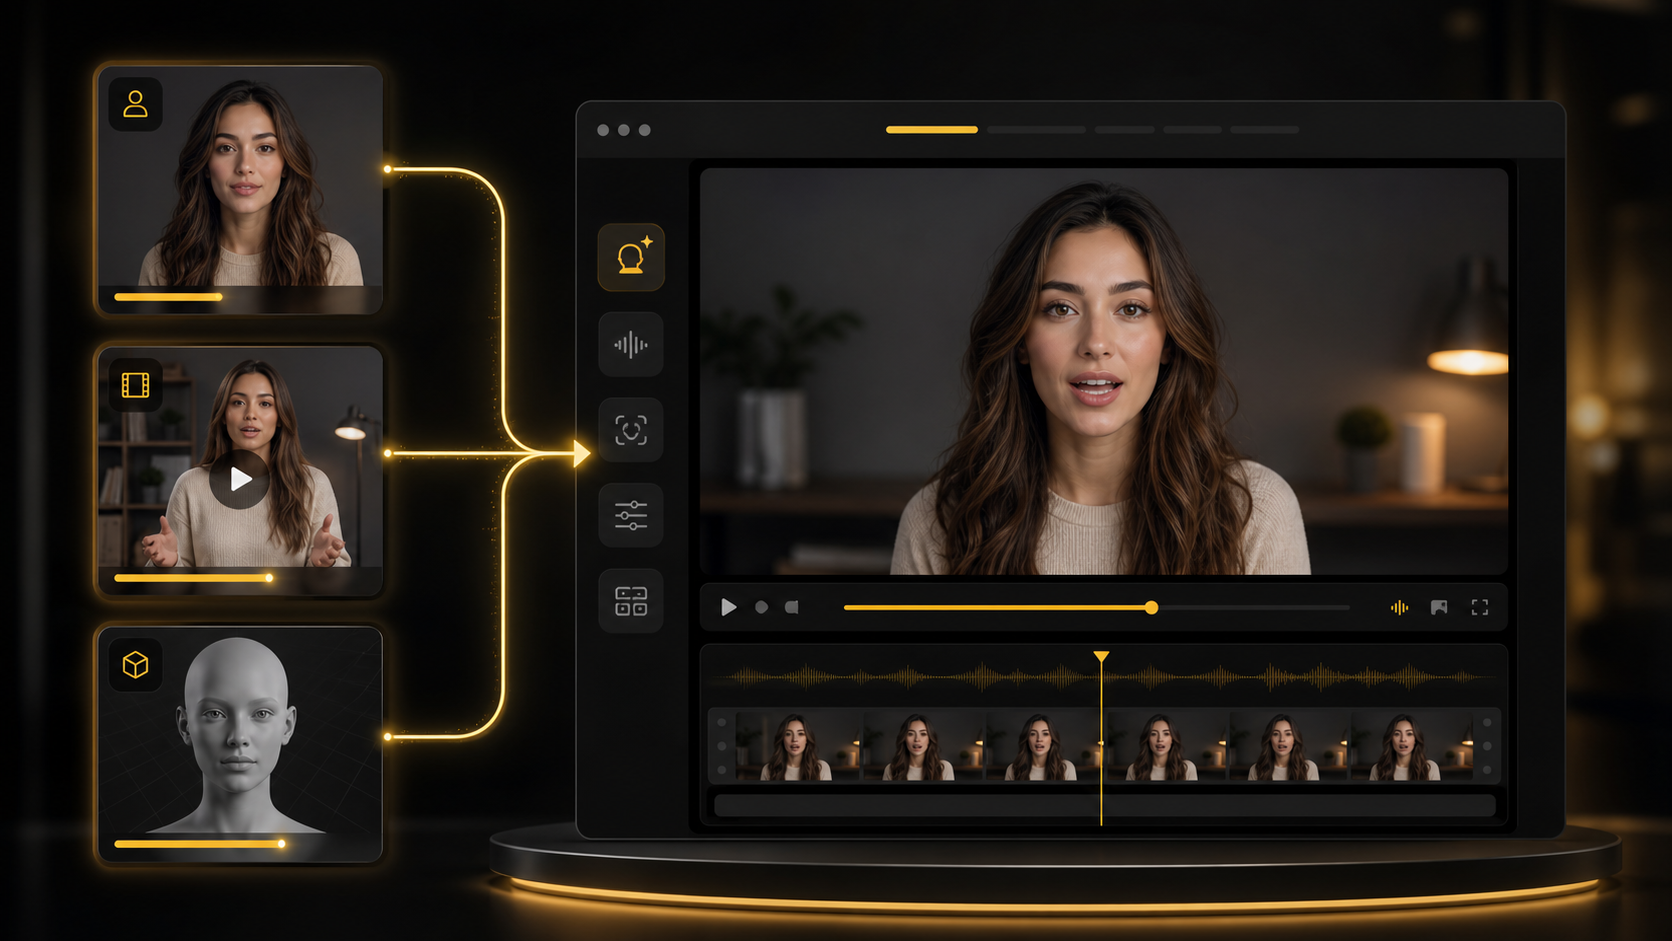
อินพุตรูปภาพ วิดีโอ และอวตาร
เริ่มต้นด้วยภาพบุคคลที่ชัดเจน วิดีโอที่มีอยู่ รูปประจำตัวตัวอย่าง หรือภาพประจำตัวที่สร้างโดย AI เมื่อคุณไม่มีฟุตเทจต้นฉบับพร้อม
อินพุตรูปภาพ/วิดีโออวตารพร้อมแล้ว
1. Upload Video
2. Enter your text, upload or record audio
3. Model Selection
Fast กำหนดความละเอียดเอาต์พุตโดยอัตโนมัติ เลือก 720p เพื่อเปลี่ยนเป็น Pro
1080p, 2K และ 4K ได้จากการปรับปรุงคุณภาพวิดีโอ Pro ความละเอียด 720p การปรับปรุงคุณภาพอาจไม่สามารถแก้ไขใบหน้าที่บิดเบี้ยวได้
No recent outputs yet.
Lipsync Studio
AudioToVideoAI Studio คือพื้นที่ทำงานของ AI ลิปซิงค์บนเบราว์เซอร์สำหรับผู้สร้างที่ต้องการวิดีโอที่พูดเร็ว คลิปเพลง วิดีโอที่แปล และฉากบทสนทนาสำหรับสองคนโดยไม่ต้องมีทีมงานกล้องหรือตั้งค่าการแก้ไขเดสก์ท็อป
จากสื่อต้นทางไปจนถึงวิดีโอที่ซิงค์
สตูดิโอผสมผสานสื่อต้นทาง การป้อนข้อมูลด้วยเสียง การเลือกโมเดล การแสดงตัวอย่าง และการควบคุมการส่งออก เพื่อให้คุณสามารถย้ายจากแนวคิดไปเป็นวิดีโอลิปซิงค์ที่เสร็จแล้วได้ในที่เดียว
เริ่มต้นด้วยภาพบุคคลที่ชัดเจน วิดีโอที่มีอยู่ รูปประจำตัวตัวอย่าง หรือภาพประจำตัวที่สร้างโดย AI เมื่อคุณไม่มีฟุตเทจต้นฉบับพร้อม

กระตุ้นการเคลื่อนไหวของปากด้วยเสียงที่อัปโหลด การบันทึกของเบราว์เซอร์ คำพูดที่สร้างขึ้น หรือสคริปต์ที่แปลสำหรับเวิร์กโฟลว์การแปล
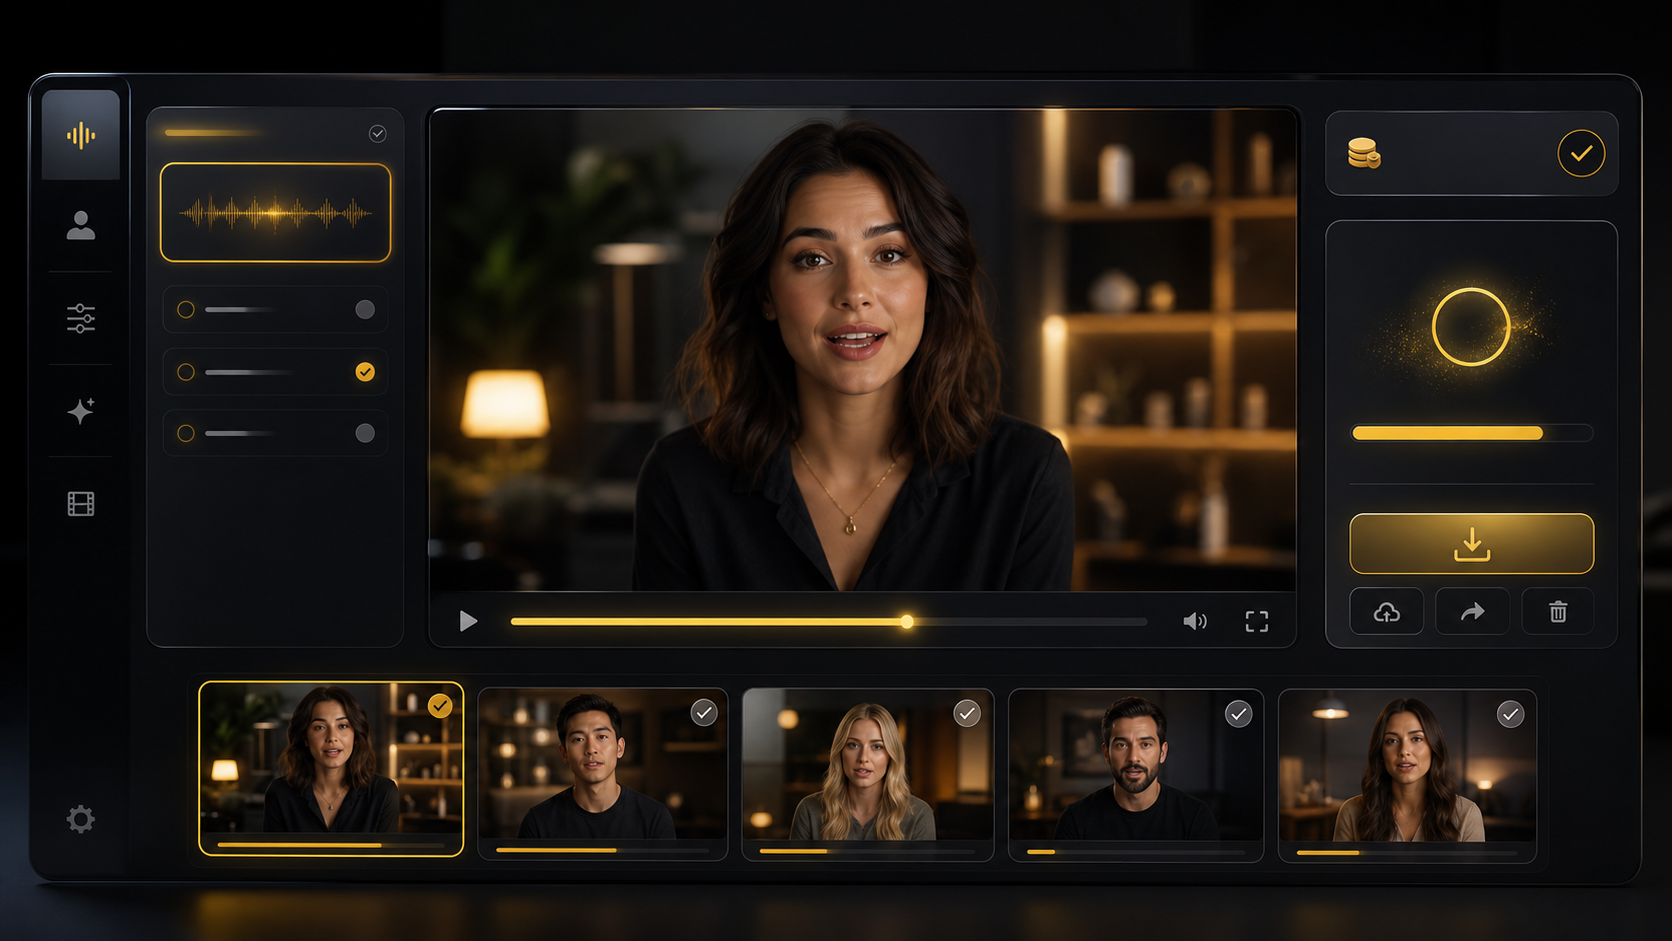
ตรวจสอบเวลา เสียง ความละเอียด และตัวเลือกรุ่นก่อนที่จะใช้เครดิตกับเอาต์พุตทั้งหมด
ผลลัพธ์ของการลิปซิงค์ที่สะอาดตาขึ้นอยู่กับการตัดสินใจ 3 ประการ ได้แก่ แหล่งที่มาของใบหน้า เสียงหรือสคริปต์การขับรถ และการตั้งค่าโมเดลสำหรับการเรนเดอร์ขั้นสุดท้าย
ขั้นตอนที่ 1
อัปโหลดภาพด้านหน้า ใช้วิดีโอที่มีอยู่ เลือกอวตารในตัว หรือสร้างภาพอวตารใหม่โดยตรงภายใน Studio
ขั้นตอนที่ 2
อัปโหลดเสียง บันทึกในเบราว์เซอร์ วางสคริปต์สำหรับการอ่านออกเสียงข้อความ หรือแปลสคริปต์วิดีโอก่อนแสดงผล
ขั้นตอนที่ 3
เลือกรุ่นและความละเอียดของลิปซิงค์ ตรวจสอบเครดิตโดยประมาณ จากนั้นสร้างวิดีโอที่สามารถดาวน์โหลดหรือเปิดได้จากห้องสมุดของคุณ
ใช้รูปแบบอินพุตที่ตรงกับโปรเจ็กต์ของคุณ แทนที่จะเปลี่ยนเครื่องมือสำหรับแต่ละขั้นตอนการผลิต
เปลี่ยนภาพบุคคล พิธีกร ตัวละครในผลิตภัณฑ์ สัตว์เลี้ยง หรืออวตารที่มีสไตล์ให้เป็นวิดีโอพูดสั้นๆ
จับคู่การเคลื่อนไหวของปากกับเสียงพากย์ เพลง พอดแคสต์ โฆษณา หรือแทร็กคำบรรยาย
แยกหรือเพิ่มสคริปต์ ดูตัวอย่างเสียงที่แปล และสร้างวิดีโอที่แปลเป็นภาษาท้องถิ่นพร้อมการเคลื่อนไหวของปากที่ประสานกัน
ใช้ Lipsync Studio เมื่อวิดีโอต้องการใบหน้าพูด เสียงที่แปลแล้ว หรือผู้นำเสนอที่นำมาใช้ซ้ำได้โดยไม่ต้องถ่ายทำใหม่
ทดสอบโฆษก ภาษา และสคริปต์หลายคนสำหรับ TikTok, Reels, Shorts และแคมเปญโซเชียลที่ต้องเสียค่าใช้จ่าย
สร้างคลิปสไตล์การร้องเพลง ช่วงเวลาเนื้อเพลง วิดีโอมีม และภาพสไตล์การแสดงจากเสียง
ปรับผู้อธิบายผลิตภัณฑ์ บทเรียนในหลักสูตร การสาธิต และวิดีโอของผู้สร้างสำหรับผู้ชมใหม่ ๆ ด้วยคำพูดที่ประสานกัน
สร้างคลิปสัมภาษณ์ พอดแคสต์ การแสดงบทบาทสมมติ การขาย หรือการศึกษาที่วิทยากรสองคนผลัดกันในเฟรมเดียว
สตูดิโอได้รับการออกแบบมาเพื่อการผลิตซ้ำ: อินพุตที่ชัดเจน ต้นทุนที่มองเห็นได้ ผลลัพธ์ที่นำมาใช้ซ้ำได้ และการควบคุมที่ช่วยลดการเรนเดอร์ที่ไม่ดีก่อนที่จะเกิดขึ้น
เลือกรุ่นที่เร็วกว่าสำหรับการทดสอบอย่างรวดเร็วหรือรุ่นคุณภาพสูงกว่า เมื่อจังหวะ ความละเอียด หรือเสียงที่ยาวขึ้นมีความสำคัญ
ครอบตัดรูปภาพ สร้างอวตาร เปลี่ยนสไตล์เสียง ดูตัวอย่างคำพูด และกู้คืนจากปัญหาเรื่องค่าเสียงที่ยาวนานโดยไม่ต้องออกจากหน้า
ผลลัพธ์ล่าสุดจะยังคงมองเห็นได้ใน Studio และงานที่เสร็จแล้วสามารถดาวน์โหลด แชร์ หรือเปิดได้ในภายหลังจาก My Creations
Studio แสดงเครดิตโดยประมาณก่อนการสร้าง ดังนั้นคุณจึงสามารถปรับความยาว รุ่น และความละเอียดของเสียงได้ก่อนที่จะทำการเรนเดอร์แบบเต็ม
สร้างขึ้นเพื่อการควบคุมต้นทุน
การแสดงตัวอย่างเสียงจะสามารถใช้งานได้ฟรีก่อนการเรนเดอร์ครั้งสุดท้าย
การอัปเดตประมาณการเครดิตพร้อมระยะเวลาและการแก้ไข
ข้อความแจ้งการเติมเงินจะคงการตั้งค่าปัจจุบันของคุณไว้
Lipsync Studio คือพื้นที่ทำงาน AudioToVideoAI สำหรับการสร้างวิดีโอ AI ลิปซิงค์ทางออนไลน์ โดยผสมผสานการอัปโหลดสื่อ การป้อนข้อมูลเสียงหรือสคริปต์ การตั้งค่าโมเดล การแสดงตัวอย่าง การเรนเดอร์ ดาวน์โหลด และการเข้าถึงไลบรารีไว้ในหน้าเดียว
ใช่ อัปโหลดภาพบุคคลหรือเลือกอวาตาร์ตัวอย่าง เพิ่มเสียงหรือสคริปต์ จากนั้นสร้างวิดีโอพูดคุยพร้อมการเคลื่อนไหวของปากที่ประสานกัน
ใช่ โหมดการแปลวิดีโอสามารถทำงานร่วมกับวิดีโอต้นฉบับ การแยกสคริปต์ ข้อความที่แปล การแสดงตัวอย่างเสียง และเอาต์พุตลิปซิงค์สำหรับโปรเจ็กต์การแปลเป็นภาษาท้องถิ่น
Studio รองรับคลิปเสียงสูงสุด 10 นาที คลิปที่ยาวกว่าอาจทำให้ใช้เครดิตมากขึ้น ดังนั้นหน้านี้จึงแสดงตัวเลือกการประมาณการและการกู้คืนก่อนการเรนเดอร์ขั้นสุดท้าย
ใบหน้าที่หันไปทางด้านหน้าที่ชัดเจนและปากที่มองเห็นได้มักจะให้ผลลัพธ์ที่ดีที่สุด การจัดแสงที่ดี ภาพที่คมชัด และเสียงที่ชัดเจนช่วยให้โมเดลสร้างการเคลื่อนไหวของปากที่เป็นธรรมชาติมากขึ้น
ไม่ โหมดลิปซิงค์หลักทำงานได้ดีสำหรับลำโพงตัวเดียว และโหมดหลายบทสนทนาได้รับการออกแบบมาสำหรับฉากที่มีสองคนโดยมีป้ายกำกับและเสียงของผู้พูดแยกกัน